Варианты загрузки данных
Загрузка данных — это процесс очистки и преобразования сырых данных из различных источников данных в соответствии с вашими бизнес-требованиями и загрузки полученных данных в Selena для облегчения анализа.
Selena предоставляет множество вариантов для загрузки данных:
- Методы загрузки: Insert, Stream Load, Broker Load, Pipe, Routine Load и Spark Load
- Инструменты экосистемы: Selena Connector для Apache Kafka® (сокращенно Kafka connector), Selena Connector для Apache Spark™ (сокращенно Spark connector), Selena Connector для Apache Flink® (сокращенно Flink connector) и другие инструменты, такие как SMT, DataX, CloudCanal и Kettle Connector
- API: интерфейс транзакций Stream Load
Каждый из этих вариантов имеет свои преимущества и поддерживает свой набор систем источников данных для извлечения.
Эта тема предоставляет обзор этих вариантов, а также сравнения между ними, чтобы помочь вам определить подходящий вариант загрузки на основе вашего источника данных, бизнес-сценария, объема данных, формата файлов данных и частоты загрузки.
Введение в варианты загрузки
Этот раздел в основном описывает характеристики и бизнес-сценарии вариантов загрузки, доступных в Selena.
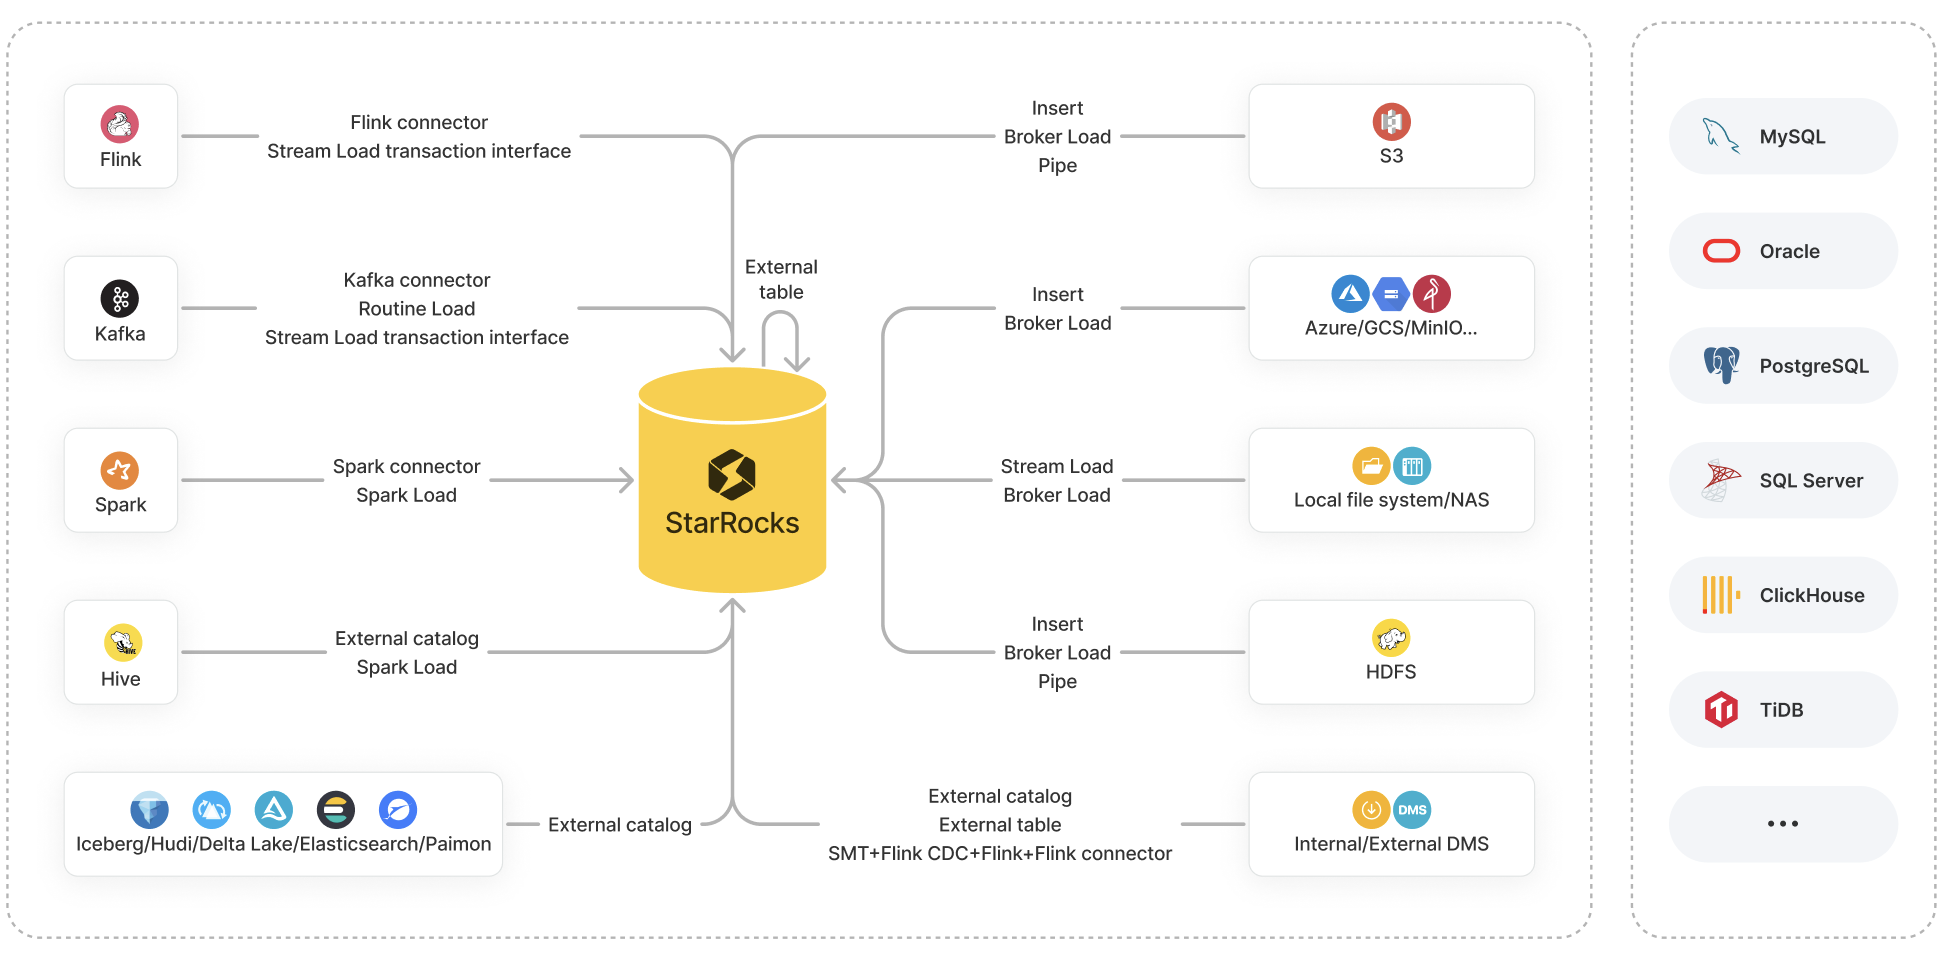
В следующих разделах "пакетная" или "пакетная загрузка" относится к загрузке большого объема данных из указанного источника за один раз в Selena, тогда как "потоковая" или "потоковая передача" относится к непрерывной загрузке данных в реальном времени.
Методы загрузки
Insert
Бизнес-сценарий:
- INSERT INTO VALUES: Добавление в внутреннюю таблицу небольших объемов данных.
- INSERT INTO SELECT:
-
INSERT INTO SELECT FROM
<table_name>: Добавление в таблицу результата запроса к внутренней или внешней таблице. -
INSERT INTO SELECT FROM FILES(): Добавление в таблицу результата запроса к файлам данных в удаленном хранилище.
примечаниеДля AWS S3 эта функция поддерживается начиная с версии 1.5.0. Для HDFS, Microsoft Azure Storage, Google GCS и S3-совместимого хранилища (такого как MinIO) эта функция поддерживается начиная с версии 1.5.0.
-
Формат файла:
- INSERT INTO VALUES: SQL
- INSERT INTO SELECT:
- INSERT INTO SELECT FROM
<table_name>: таблицы Selena - INSERT INTO SELECT FROM FILES(): Parquet и ORC
- INSERT INTO SELECT FROM
Объем данных: Не фиксирован (Объем данных зависит от размера памяти.)
Stream Load
Бизнес-сценарий: Пакетная загрузка данных из локальной файловой системы.
Формат файла: CSV и JSON
Объем данных: 10 ГБ или менее
Broker Load
Бизнес-сценарий:
- Пакетная загрузка данных из HDFS или облачного хранилища, такого как AWS S3, Microsoft Azure Storage, Google GCS и S3-совместимое хранилище (например, MinIO).
- Пакетная загрузка данных из локальной файловой системы или NAS.
Формат файла: CSV, Parquet, ORC и JSON (поддерживается с версии 3.2.3)
Объем данных: Десятки ГБ до сотен ГБ
Pipe
Бизнес-сценарий: Пакетная загрузка или потоковая передача данных из HDFS или AWS S3.
Этот метод загрузки поддерживается начиная с версии 1.5.0.
Формат файла: Parquet и ORC
Объем данных: 100 ГБ до 1 ТБ или более
Routine Load
Бизнес-сценарий: Потоковая передача данных из Kafka.
Формат файла: CSV, JSON и Avro (поддерживается с версии 3.0.1)
Объем данных: МБ до ГБ данных в виде мини-пакетов
Spark Load
Бизнес-сценарий: Пакетная загрузка данных таблиц Apache Hive™, хранящихся в HDFS, с использованием кластеров Spark.
Формат файла: CSV, Parquet (поддерживается с версии 2.0) и ORC (поддерживается с версии 2.0)
Объем данных: Десятки ГБ до ТБ
Инструменты экосистемы
Kafka connector
Бизнес-сценарий: Потоковая передача данных из Kafka.
Spark connector
Бизнес-сценарий: Пакетная загрузка данных из Spark.
Flink connector
Бизнес-сценарий: Потоковая передача данных из Flink.
SMT
Бизнес-сценарий: Загрузка данных из источников данных, таких как MySQL, PostgreSQL, SQL Server, Oracle, Hive, ClickHouse и TiDB через Flink.
DataX
Бизнес-сценарий: Синхронизация данных между различными разнородными источниками данных, включая реляционные базы данных (например, MySQL и Oracle), HDFS и Hive.
CloudCanal
Бизнес-сценарий: Миграция или синхронизация данных из исходных баз данных (например, MySQL, Oracle и PostgreSQL) в Selena.
Kettle Connector
Бизнес-сценарий: Интеграция с Kettle. Объединяя мощные возможности обработки и преобразования данных Kettle с высокопроизводительными возможностями хранения и анализа данных Selena, можно достичь более гибких и эффективных рабочих процессов обработки данных.
API
Интерфейс транзакций Stream Load
Бизнес-сценарий: Реализация двухфазной фиксации (2PC) для транзакций, которые выполняются для загрузки данных из внешних систем, таких как Flink и Kafka, при одновременном улучшении производительности высококонкурентных потоковых загрузок. Эта функция поддерживается начиная с версии 1.5.0.
Формат файла: CSV и JSON
Объем данных: 10 ГБ или менее
Выбор вариантов загрузки
Этот раздел перечисляет варианты загрузки, доступные для общих источников данных, помогая вам выбрать вариант, который лучше всего подходит для вашей ситуации.
Объектное хранилище
| Источник данных | Доступные варианты загрузки |
|---|---|
| AWS S3 |
|
| Microsoft Azure Storage |
|
| Google GCS |
|
| S3-совместимое хранилище (например, MinIO) |
|
Локальная файловая система (включая NAS)
| Источник данных | Доступные варианты загрузки |
|---|---|
| Локальная файловая система (включая NAS) |
|
HDFS
| Источник данных | Доступные варианты загрузки |
|---|---|
| HDFS |
|
Flink, Kafka и Spark
| Источник данных | Доступные варианты загрузки |
|---|---|
| Apache Flink® | |
| Apache Kafka® |
Если исходные данные требуют соединения нескольких таблиц и операций извлечения, преобразования и загрузки (ETL), вы можете использовать Flink для чтения и предварительной обработки данных, а затем использовать Flink connector для загрузки данных в Selena. |
| Apache Spark™ |
Озера данных
| Источник данных | Доступные варианты загрузки |
|---|---|
| Apache Hive™ |
|
| Apache Iceberg | (Пакетная) Создайте Iceberg catalog и затем используйте INSERT INTO SELECT FROM <table_name>. |
| Apache Hudi | (Пакетная) Создайте Hudi catalog и затем используйте INSERT INTO SELECT FROM <table_name>. |
| Delta Lake | (Пакетная) Создайте Delta Lake catalog и затем используйте INSERT INTO SELECT FROM <table_name>. |
| Elasticsearch | (Пакетная) Создайте Elasticsearch catalog и затем используйте INSERT INTO SELECT FROM <table_name>. |
| Apache Paimon | (Пакетная) Создайте Paimon catalog и затем используйте INSERT INTO SELECT FROM <table_name>. |
Обратите внимание, что Selena предоставляет унифицированные каталоги начиная с версии 1.5.0, чтобы помочь вам обрабатывать таблицы из источников данных Hive, Iceberg, Hudi и Delta Lake как единый источник данных без приема.
Внутренние и внешние базы данных
| Источник данных | Доступные варианты загрузки |
|---|---|
| Selena | (Пакетная) Создайте внешнюю таблицу Selena и затем используйте INSERT INTO VALUES для вставки нескольких записей данных или INSERT INTO SELECT FROM <table_name> для вставки данных таблицы.ПРИМЕЧАНИЕ Внешние таблицы Selena поддерживают только запись данных. Они не поддерживают чтение данных. |
| MySQL |
|
| Другие базы данных, такие как Oracle, PostgreSQL, SQL Server, ClickHouse и TiDB |
|